
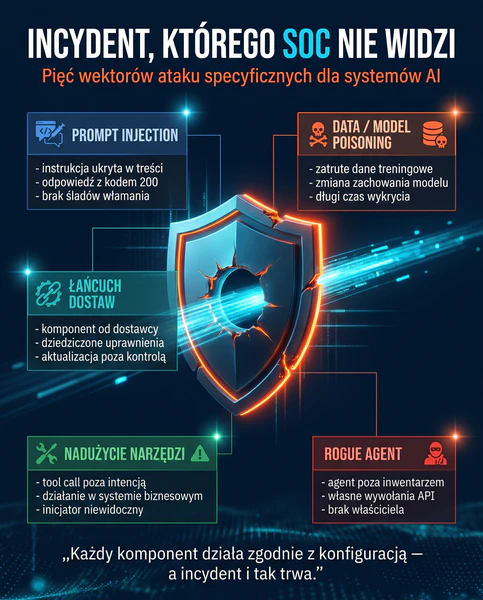
Prompt injection nie zostawia malware’u, skompromitowanych poświadczeń ani śladów włamania. Z perspektywy sieci to poprawne wywołanie API z kodem 200. Właśnie dlatego reagowanie na incydenty AI wymaga przebudowy playbooków — zanim pierwszy z nich okaże się potrzebny.
Twój SOC wykryje ransomware. Ale czy wykryje agenta AI, który po zmanipulowanej instrukcji pobiera dane przez API — w ramach swoich uprawnień?
Wstęp
Reagowanie na incydenty związane z systemami sztucznej inteligencji stało się w 2026 roku odrębną dyscypliną operacyjną — i zarazem obowiązkiem regulacyjnym, którego większość organizacji nie zdążyła jeszcze przełożyć na procedury.
Trzy lata po wejściu generatywnej AI do przedsiębiorstw większość organizacji ma już inwentarz systemów AI, politykę dopuszczalnego użycia i proces zatwierdzania nowych zastosowań. Publikacja Cloud Security Alliance (CSA) autorstwa zespołu Deloitte Italy zwraca jednak uwagę, że znacznie mniej organizacji potrafi odpowiedzieć na pytanie pozornie proste: „what exactly do we do on the day one of these tools is compromised?„. Dojrzałe playbooki istnieją dla ransomware, kompromitacji poczty biznesowej czy przejęcia konta chmurowego — ale nie dla scenariusza, w którym prompt injection działał w produkcyjnym asystencie AI przez trzy tygodnie, zanim ktokolwiek to zauważył.
Dla audytora i pełnomocnika systemu zarządzania to temat podwójnie istotny: podważa założenia, na których zbudowano klasyczne procedury zarządzania incydentami, i jednocześnie trafia w moment, w którym zgłaszanie poważnych incydentów AI stało się obowiązkiem prawnym. Poniżej oś wywodu: dlaczego dotychczasowe playbooki zawodzą, jak odpowiadają na to normy ISO i od czego zacząć.
Dlaczego incydenty AI wymykają się klasycznym procedurom
Sedno problemu autorzy publikacji ujmują następująco: tradycyjne ramy reagowania na incydenty zakładają właściwości, których systemy AI nie mają — deterministyczne zachowanie, podatności możliwe do załatania i dowody znajdujące się w znanych miejscach, takich jak logi systemowe czy obrazy dysków. Gdy te założenia przestają obowiązywać, przestaje działać playbook.
Incydent w warstwie semantycznej, nie infrastrukturalnej
Publikacja proponuje roboczą definicję: incydent bezpieczeństwa AI to zdarzenie naruszające poufność, integralność lub dostępność systemu AI — albo danych i narzędzi, do których system ten sięga — poprzez wektory ataku specyficzne dla AI, niewykrywalne klasycznymi mechanizmami. Katalog obejmuje prompt injection, zatruwanie danych i modeli (data/model poisoning), ataki na łańcuch dostaw, nadużycie narzędzi udostępnionych modelowi oraz wdrożenie nieautoryzowanego agenta.
Wspólny mianownik jest znamienny: żaden z tych scenariuszy nie wymaga malware’u, przejętych poświadczeń ani włamania sieciowego. Autorzy obrazują to przykładem: atakujący, który manipulacją skłania chatbota obsługi klienta do ujawnienia danych innego użytkownika, jest z perspektywy sieci kolejnym wywołaniem API zakończonym kodem 200. Incydent materializuje się w warstwie aplikacyjnej i semantycznej — tam, gdzie klasyczny SOC nie patrzy.
Wagę problemu podnosi wejście agentów AI do produkcji. Według raportu Deloitte „State of AI in the Enterprise 2026”, przywołanego w publikacji, 74% organizacji spodziewa się do 2027 roku co najmniej umiarkowanego wykorzystania agentów AI, ale tylko 21% deklaruje dojrzały model governance dla agentic AI. Powierzchnią ataku przestaje być pojedynczy model — stają się nią łańcuchy agentów wywołujących się nawzajem, często z dziedziczonymi uprawnieniami i ograniczoną obserwowalnością.
Nie ma odpowiedzi bez logowania
Publikacja stawia tezę, że zarządzanie incydentem AI zaczyna się na długo przed incydentem — od logowania. Minimalny zakres rejestrowanych danych obejmuje prompty kierowane do modelu, generowane odpowiedzi, wywołania narzędzi i funkcji, zapytania do systemu retrieval oraz kontekst tożsamości stojącej za każdą interakcją. Bez tego zapisu nie sposób ustalić, co się stało, kiedy się zaczęło i jak daleko sięgnęło.
Autorzy uczciwie nazywają napięcie, które to rodzi: prompty rutynowo zawierają dane osobowe i informacje poufne, więc pełne logowanie konwersacji tworzy nowe ryzyko prawne. Odpowiedzią nie jest rezygnacja z logów, lecz traktowanie ich jak archiwów danych wrażliwych — z rygorystyczną kontrolą dostępu, ograniczoną retencją i maskowaniem tam, gdzie to wykonalne.
Dla środowisk agentowych publikacja idzie o krok dalej: logowanie pojedynczych zdarzeń bez korelacji zaciera łańcuch przyczynowy ataku, który może rozciągać się na wielu agentów, operacje retrieval i wywołania narzędzi. Potrzebne jest śledzenie rozproszone (distributed tracing), łączące pojedyncze działania w kompletne przebiegi za pomocą unikalnych identyfikatorów. Sama detekcja musi zaś działać warstwowo — reguły wzorcowe dla znanych payloadów, klasyfikatory intencji semantycznej niezależne od sformułowania oraz wykrywanie anomalii behawioralnych — i obejmować zarówno wejścia, jak i wyjścia systemu.
Containment bez wyłącznika i forensyka bez powtarzalności
W klasycznym reagowaniu izoluje się hosta albo blokuje konto. Publikacja wskazuje, że dla asystenta AI wbudowanego w procesy biznesowe równoważne decyzje są trudniejsze: pełne wyłączenie systemu klienckiego bywa najbezpieczniejsze, ale kosztowne. Autorzy postulują więc gradowaną strategię containmentu, ćwiczoną z wyprzedzeniem — zdolność odcięcia agentowi dostępu do konkretnego konektora w kilka minut, bez ponownego wdrażania całej aplikacji, oddziela chirurgiczne opanowanie incydentu od przestoju usługi. Działania warto mapować na scenariusze z katalogu MITRE ATLAS, z jasno przypisaną odpowiedzialnością i rozdzieleniem containmentu od eradykacji.
Jeszcze ciekawszy jest wątek śledczy. System niedeterministyczny nie odtwarza wiarygodnie własnego zachowania — ten sam złośliwy prompt może zadziałać w jednej sesji i zawieść w następnej. Forensyka opiera się więc na rekonstrukcji zdarzeń z logów interakcji (replay), nie na ponownym wykonaniu. Publikacja odnotowuje przy tym paradoks: gdy zespół reagowania próbuje analizować wrogie payloady z użyciem modeli frontier, mechanizmy bezpieczeństwa tych modeli potrafią odmówić analizy, traktując badany materiał jak treść zakazaną. Obrońca zostaje zablokowany przez zabezpieczenia projektowane przeciw napastnikom — stąd rekomendacja zapewnienia nadzorowanego dostępu do modeli alternatywnych na potrzeby dochodzeń. Ocena zasięgu incydentu również zmienia perspektywę: kluczowe pytanie brzmi nie tylko „co zrobił atakujący”, lecz „co było osiągalne z przejętej sesji” — które dokumenty w systemie RAG, które narzędzia, które systemy downstream ufające odpowiedziom modelu.
Remediacja to nie patch
Dla większości podatności oprogramowania odzyskanie sprawności kończy się łatką. Według publikacji remediacja systemu AI może wymagać wzmocnienia promptu systemowego, przebudowy guardraili, zawężenia uprawnień, dostrojenia modelu lub migracji do nowej wersji — a każda z tych zmian może zmienić zachowanie systemu w obszarach pozornie niepowiązanych. Stąd obowiązkowy element odzyskiwania: regresyjne testy adwersarialne i funkcjonalne potwierdzające, że poprawka zamyka wykorzystaną ścieżkę, nie otwierając nowych. Każdy incydent powinien zasilać model zagrożeń, reguły monitorowania i kolejną rundę testów — inaczej organizacja będzie odpowiadać na ten sam incydent pod różnymi nazwami.
Perspektywa norm ISO
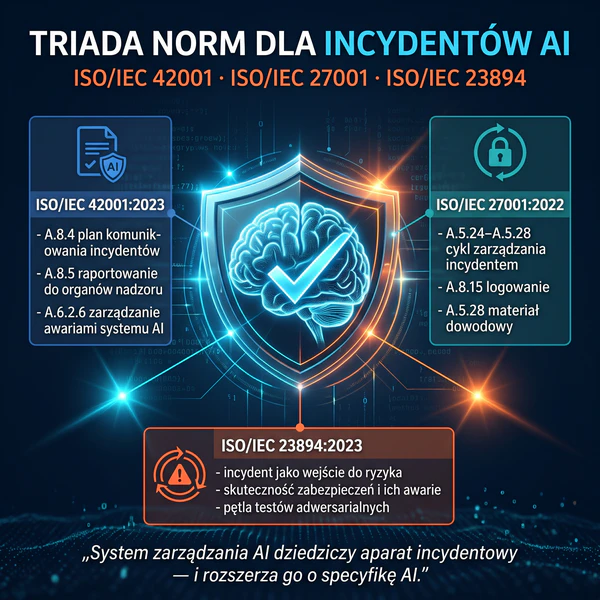
Tezy publikacji nie wymagają budowania nowych ram od zera — układają się w wymagania, które istnieją w normach systemów zarządzania, choć rzadko są czytane pod kątem AI. Kluczem jest integracja: system zarządzania AI dziedziczy aparat incydentowy bezpieczeństwa informacji i rozszerza go o specyfikę systemów niedeterministycznych.
ISO/IEC 42001:2023 — incydent AI jako obowiązek systemowy
Postulat publikacji, by odpowiedź na incydenty AI była zaprojektowana przed incydentem, ISO/IEC 42001:2023 przekłada na wymagania wprost. Zabezpieczenie A.8.4 nakazuje określić i udokumentować plan komunikowania incydentów użytkownikom systemu — a wytyczne wdrożeniowe precyzują, że organizacja powinna rozumieć swoje obowiązki notyfikacyjne zależnie od kontekstu: jakie typy incydentów podlegają zgłoszeniu, w jakim terminie, którym organom i w jakim zakresie. Zabezpieczenie A.8.5 idzie dalej: obliguje do udokumentowania obowiązków raportowania informacji o systemie AI stronom zainteresowanym, włącznie z organami nadzoru — z logami i rejestrami systemowymi jako przykładowym zakresem. To dokładnie ta zdolność, której wymaga opisany niżej art. 73 AI Act. Wątek operacyjny domykają A.6.2.6 (udokumentowane procedury eksploatacji: plan zarządzania awariami, rollback, priorytetyzacja i przegląd logów zdarzeń) oraz A.3.3 (kanał zgłaszania obaw w całym cyklu życia systemu). Co istotne, wytyczne normy wprost dopuszczają integrację reagowania na incydenty AI z szerszym zarządzaniem incydentami organizacji — przy zachowaniu wymagań specyficznych dla AI.
ISO/IEC 27001:2022 — aparat incydentowy, który trzeba rozszerzyć, nie zastąpić
Cały opisany przez publikację cykl — przygotowanie, ocena, reakcja, wnioski, dowody — ma swoje umocowanie w zabezpieczeniach A.5.24–A.5.28 ISO/IEC 27001:2022. Teza „nie ma odpowiedzi bez logowania” to operacyjne odczytanie A.8.15 (logowanie) i A.8.16 (monitorowanie); wymóg forensyki opartej na replay trafia wprost w A.5.28 (zbieranie materiału dowodowego). Problem, który publikacja diagnozuje, nie polega więc na braku wymagań, lecz na ich domyślnej interpretacji: procedury zaprojektowane dla infrastruktury klasycznej formalnie spełniają zabezpieczenia, ale nie „widzą” zdarzeń w warstwie semantycznej. Audyt zintegrowanego systemu powinien czytać A.5.24–A.5.28 przez pryzmat scenariuszy AI — i właśnie tu domykają się oba systemy zarządzania.
ISO/IEC 23894:2023 — incydent jako wejście do zarządzania ryzykiem
Zamykającą pętlę publikacji — incydent zasila model zagrożeń i kolejne testy — normatywnie porządkuje ISO/IEC 23894:2023. Norma wskazuje raporty o incydentach podobnych systemów jako źródło identyfikacji ryzyka, każe uwzględniać skuteczność operacyjną zabezpieczeń wraz z ich awariami i wpisuje rejestrowanie oraz raportowanie w cykl zarządzania ryzykiem AI. Regresja adwersarialna po każdej zmianie modelu przestaje być dobrą praktyką inżynierską, a staje się elementem udokumentowanego postępowania z ryzykiem.
Kontekst regulacyjny: art. 73 AI Act
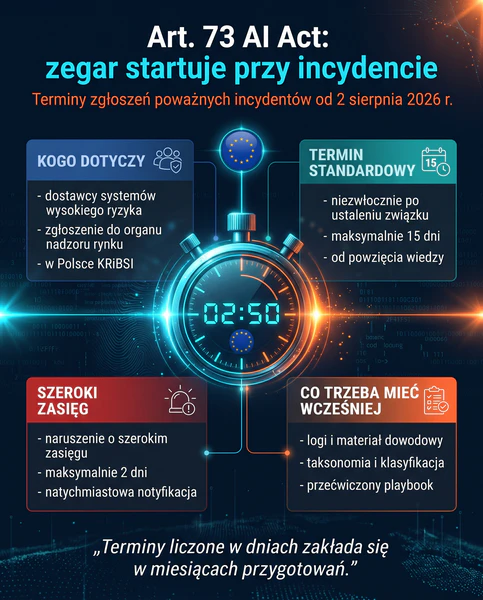
Od 2 sierpnia 2026 r. stosuje się art. 73 rozporządzenia (UE) 2024/1689 (AI Act): dostawcy systemów AI wysokiego ryzyka zgłaszają poważne incydenty organowi nadzoru rynku — niezwłocznie po ustaleniu związku przyczynowego między systemem a incydentem lub uzasadnionego prawdopodobieństwa takiego związku, nie później niż 15 dni od powzięcia wiedzy, a przy naruszeniu o szerokim zasięgu w terminie do 2 dni. Terminy tej skali są nieosiągalne bez wcześniej zbudowanej zdolności: bez logów nie ma ustalenia związku przyczynowego, bez taksonomii nie ma klasyfikacji, bez przećwiczonego playbooka nie ma decyzji w terminie. W Polsce właściwość organów i procedury nadzoru określa ustawa z dnia 3 lipca 2026 r. o systemach sztucznej inteligencji (Dz.U. 2026 poz. 1003), powołująca Komisję Rozwoju i Bezpieczeństwa Sztucznej Inteligencji — podział ról dostawcy i podmiotu stosującego omówiliśmy odrębnie na blogu.
Z praktyki audytora
W audytach organizacji korzystających z AI powtarza się charakterystyczny wzorzec. Procedura zarządzania incydentami dobrze „widzi” malware, phishing, przejęcie konta czy wyciek danych — ale na pytanie, co według niej jest incydentem bezpieczeństwa związanym z AI, często nie ma odpowiedzi, bo taka kategoria zdarzeń w ogóle nie istnieje. Podobnie z dowodami logowania: organizacje pokazują to, co otacza AI — uwierzytelnienie, ruch sieciowy, dashboard SIEM — czyli odpowiedź na pytanie „kto i kiedy korzystał z usługi”, nie „co właściwie zrobił system AI”. Skutecznym testem jest prośba o odtworzenie jednej rzeczywistej interakcji od uwierzytelnienia użytkownika, przez prompt i kontekst, po działanie wykonane przez narzędzie lub agenta. A przy deklarowanych ćwiczeniach playbooka najbardziej diagnostyczne bywa pytanie: „co zmieniliście po tym ćwiczeniu?” — odpowiedź „nic, wszystko zadziałało” zwykle oznacza, że test nie był rzetelny.
Praktyczne impplikacje
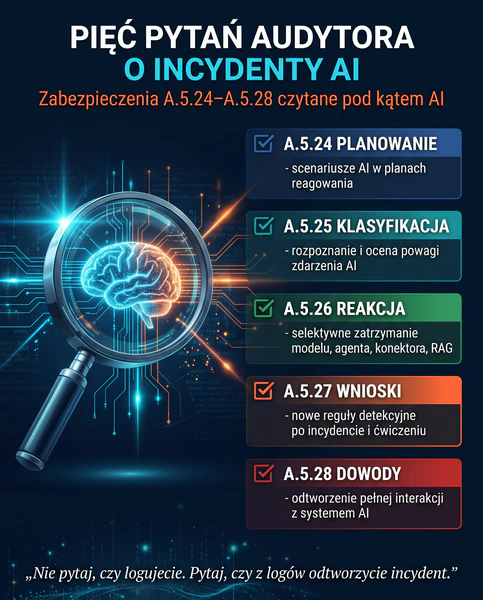
Syntezę tez publikacji i wymagań normatywnych można sprowadzić do pięciu pytań kontrolnych, które warto zadać we własnej organizacji — układają się one wzdłuż zabezpieczeń ISO/IEC 27001, czytanych pod kątem AI:
| Zabezpieczenie | Pytanie w kontekście AI |
|---|---|
| A.5.24 | Czy scenariusze AI (prompt injection, poisoning, nadużycie narzędzia przez agenta) są w planach reagowania? |
| A.5.25 | Czy organizacja potrafi rozpoznać i sklasyfikować zdarzenie AI, w tym ocenić jego powagę? |
| A.5.26 | Czy wiadomo, jak zatrzymać model, agenta, konektor, API lub dostęp do RAG — selektywnie, bez wyłączania usługi? |
| A.5.27 | Czy po incydencie lub ćwiczeniu powstają nowe reguły detekcyjne i zmiany w playbooku? |
| A.5.28 | Czy istniejące logi pozwalają odtworzyć pełną interakcję z systemem AI jako materiał dowodowy? |
Trzy działania o najlepszym stosunku efektu do nakładu. Po pierwsze, rozszerzenie taksonomii incydentów o kategorie AI wraz z kryteriami powagi uwzględniającymi nie tylko faktyczne działania modelu, lecz także jego potencjalny dostęp do danych i zasobów. Po drugie, telemetryka selektywna zamiast logowania wszystkiego: identyfikatory użytkownika, sesji, modelu i wersji, źródła RAG, wywołania narzędzi, decyzje mechanizmów kontrolnych — z pełną treścią interakcji tylko tam, gdzie uzasadnia to analiza ryzyka; to godzi wymagania dowodowe z zasadą minimalizacji danych. Po trzecie, przypisanie własności z góry: incydent AI ma naturalnie czterech gospodarzy — SOC, zespół platformy AI, właściciela aplikacji i funkcję prawno-prywatnościową — a bez rozstrzygnięcia RACI przed incydentem nie odpowiada nikt.
Podsumowanie
Publikacja CSA precyzyjnie nazywa zmianę, która dokonała się w 2026 roku: incydenty AI przestały być hipotezą, a zdolność reagowania na nie przestała być dobrą praktyką — stała się wymogiem regulacyjnym z twardymi terminami. Różnica między szybko opanowanym incydentem a kryzysem operacyjnym i regulacyjnym rozstrzyga się na długo przed atakiem: w taksonomii, logowaniu, przećwiczonym containmencie i pętli uczenia się. Normy ISO/IEC 42001 i ISO/IEC 27001 traktowane jako zintegrowana całość dają temu gotowy szkielet systemowy — od planu komunikowania incydentów, przez materiał dowodowy, po regresję według udokumentowanego postępowania z ryzykiem. Jeżeli Twoja organizacja wdraża lub certyfikuje system zarządzania AI, warto zacząć od audytu zdolności incydentowej — to obecnie najkrótsza droga do wykazania zgodności tam, gdzie regulator będzie pytał najpierw.
Bibliografia:
- R. Meghnagi, G. Ciccarelli, M. Veroni, M. Cacace, When the Playbook Breaks: AI Incident Response for Systems That Don’t Behave Like Anything Else, Cloud Security Alliance Blog, 14.08.2026, cloudsecurityalliance.org.
- ISO/IEC 42001:2023, Information technology — Artificial intelligence — Management system.
- ISO/IEC 27001:2022, Information security, cybersecurity and privacy protection — Information security management systems — Requirements.
- ISO/IEC 23894:2023, Information technology — Artificial intelligence — Guidance on risk management.
- Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2024/1689 z dnia 13 czerwca 2024 r. w sprawie ustanowienia zharmonizowanych przepisów dotyczących sztucznej inteligencji (AI Act), art. 73, eur-lex.europa.eu.
- Ustawa z dnia 3 lipca 2026 r. o systemach sztucznej inteligencji (Dz.U. 2026 poz. 1003), dziennikustaw.gov.pl.
- Deloitte, State of AI in the Enterprise 2026 (za: publikacja CSA, przypis 1).
FAQ: Incydenty AI: dlaczego klasyczne playbooki zawodzą
Incydent bezpieczeństwa AI to zdarzenie naruszające poufność, integralność lub dostępność systemu AI — albo danych i narzędzi, do których system sięga — poprzez wektory specyficzne dla AI: prompt injection, zatruwanie danych lub modelu, nadużycie narzędzi udostępnionych modelowi czy działanie nieautoryzowanego agenta. Cechą wspólną jest to, że żaden z tych scenariuszy nie wymaga malware'u ani włamania sieciowego — incydent powstaje w warstwie aplikacyjnej i semantycznej, niewidocznej dla klasycznego SOC.
Od 2 sierpnia 2026 r. stosuje się art. 73 rozporządzenia (UE) 2024/1689 (AI Act). Dostawcy systemów AI wysokiego ryzyka zgłaszają poważne incydenty organowi nadzoru rynku niezwłocznie po ustaleniu związku przyczynowego lub jego uzasadnionego prawdopodobieństwa — nie później niż 15 dni od powzięcia wiedzy, a przy naruszeniu o szerokim zasięgu w terminie do 2 dni. W Polsce organem właściwym jest Komisja Rozwoju i Bezpieczeństwa Sztucznej Inteligencji.
Minimalny zakres to: prompty kierowane do modelu, generowane odpowiedzi, wywołania narzędzi i funkcji, zapytania do systemu retrieval (RAG) oraz kontekst tożsamości użytkownika lub systemu stojącego za każdą interakcją. W środowiskach agentowych potrzebna jest dodatkowo korelacja zdarzeń w kompletne przebiegi (distributed tracing). Logi interakcji należy przy tym traktować jak archiwa danych wrażliwych — z kontrolą dostępu, ograniczoną retencją i maskowaniem.
Nie — norma dopuszcza integrację reagowania na incydenty AI z istniejącym zarządzaniem incydentami organizacji, na przykład zbudowanym według ISO/IEC 27001 (zabezpieczenia A.5.24–A.5.28). Wymaga jednak, aby proces uwzględniał specyfikę AI: udokumentowany plan komunikowania incydentów użytkownikom (A.8.4), obowiązki raportowania do organów nadzoru (A.8.5) oraz procedury eksploatacji obejmujące zarządzanie awariami systemu AI (A.6.2.6).
Ponieważ remediacja systemu AI — wzmocnienie promptu systemowego, zmiana guardraili, dostrojenie lub wymiana modelu — może zmienić zachowanie systemu w obszarach pozornie niepowiązanych z poprawką. Dlatego każde odzyskiwanie po incydencie AI powinno obejmować regresyjne testy adwersarialne i funkcjonalne, potwierdzające, że poprawka zamyka wykorzystaną ścieżkę ataku, nie otwierając nowych.

Ekspert w zakresie systemów zarządzania ISO, cyberbezpieczeństwa, compliance i AI governance. Audytor, konsultant, trener.
Ilustracje w tym wpisie zostały wygenerowane przy użyciu narzędzi sztucznej inteligencji. Treść merytoryczna powstała w redakcji COE i jest podpisana imiennie.